Apa yang Terjadi Ketika Server Kehabisan RAM
RAM penuh tidak langsung mematikan server. Linux melepas cache, memakai swap, lalu menjalankan OOM Killer. Ini urutan kejadiannya.
Dashboard monitoring berubah merah, nilai available tinggal beberapa ratus megabita, lalu sebuah proses hilang tanpa pesan yang jelas di log aplikasi. Dari luar, kesimpulannya terlihat sederhana: RAM habis, server kehabisan napas. Padahal kernel Linux sudah mengambil keputusan jauh sebelum titik itu tercapai.
Linux tidak membiarkan memori mengalir tanpa kendali. Ketika permintaan memori melebihi kapasitas, kernel melepas cache yang bisa dibuat ulang, memindahkan halaman yang jarang dipakai ke disk, dan sebagai upaya terakhir menghentikan satu proses agar sistem tetap hidup. Yang berubah hanyalah urutan dan besarnya intervensi.
Artikel ini menelusuri urutan kejadian tersebut — dari membaca angka free -h sampai menemukan bukti OOM di log kernel — supaya ketika aplikasi tiba-tiba berhenti, penyebabnya bisa ditelusuri, bukan ditebak.
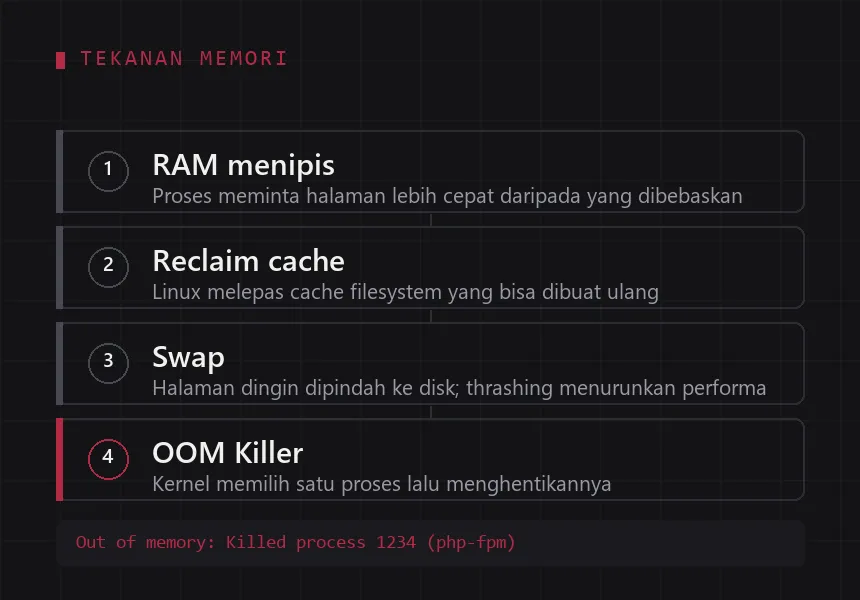
Empat tahap ini terjadi berurutan, bukan bersamaan.
1. Membaca penggunaan RAM dengan benar
RAM di server Linux dipakai untuk lebih dari sekadar menjalankan proses. Kernel juga mengisi sisa memori dengan cache filesystem dan buffer I/O, karena data yang sudah ada di memori tidak perlu dibaca ulang dari disk. Karena itu, penggunaan RAM yang tinggi belum tentu tanda masalah.
Ringkasannya terlihat dari satu perintah:
$ free -h
               total        used        free      shared  buff/cache   available
Mem:            7.7Gi       3.2Gi       1.1Gi       120Mi       3.4Gi       4.1Gi
Swap:           2.0Gi       128Mi       1.9Gi
Kolom yang perlu dibaca:
total— kapasitas RAM yang terpasang.used— memori yang sedang dipakai proses.free— memori yang benar-benar kosong.buff/cache— memori untuk cache filesystem dan buffer I/O; sebagian besar bisa dilepas saat dibutuhkan.available— perkiraan memori yang masih bisa diberikan ke proses baru tanpa swapping berat.
Untuk pertanyaan “apakah server ini masih punya ruang?”, kolom available jauh lebih berguna daripada free. Server sehat dengan free kecil dan available besar adalah kondisi normal, bukan peringatan.
2. Ketika RAM hampir penuh
Saat permintaan memori meningkat, kernel masuk ke mode reclaim. Sasaran pertamanya adalah memori yang bisa diperoleh kembali tanpa kehilangan data: page cache, cache inode dan dentry, serta halaman yang tidak lagi disentuh proses mana pun.
Urutan yang kira-kira terjadi:
- Cache filesystem dilepas. Isinya masih ada di disk, hanya perlu dibaca ulang saat dibutuhkan.
- Halaman anonim yang dingin dipindahkan ke swap, kalau swap tersedia.
- Alokasi baru ditahan sebentar sambil menunggu proses lain membebaskan memori.
Selama masih ada yang bisa dilepas, aplikasi tidak merasakan apa pun selain sedikit penurunan performa. Masalah mulai muncul ketika reclaim tidak lagi cukup: waktu alokasi memanjang, latensi permintaan naik, dan log mulai menyebut kegagalan alokasi.
3. Swap bukan tambahan RAM
Swap adalah ruang di disk yang dipakai kernel untuk menampung halaman memori saat RAM tertekan. Bentuknya bisa partisi atau file, dan kehadirannya membuat server lebih tahan menghadapi lonjakan pemakaian.
Tetapi swap bukan RAM tambahan. Server dengan RAM 4 GB dan swap 2 GB tidak berubah menjadi server 6 GB. Kecepatan baca-tulis disk, bahkan NVMe sekalipun, berada jauh di bawah RAM. Ketika sistem terlalu sering memindahkan halaman bolak-balik antara RAM dan swap, performa bisa turun drastis — kondisi yang dikenal sebagai thrashing.
Pantau aktivitas swap dengan:
swapon --show
vmstat 1
Pada output vmstat, perhatikan dua kolom:
si— memori yang dibaca dari swap per detik.so— memori yang ditulis ke swap per detik.
Angka yang terus tinggi, apalagi bersamaan dengan aplikasi yang melambat, adalah tanda tekanan memori yang serius. Swap yang terpakai sedikit dan stabil bukan masalah; swap yang terus bergerak adalah.
4. OOM Killer: ketika kernel harus memilih korban
Kalau RAM dan swap sama-sama tidak cukup, kernel tidak bisa lagi menunda. Di titik itu Out Of Memory Killer berjalan: kernel memilih satu proses dan menghentikannya, supaya sistem secara keseluruhan tetap bisa dipakai. Ini keputusan yang kasar, tetapi lebih baik daripada seluruh mesin membeku karena tidak ada memori yang bisa dialokasikan.
Proses yang dipilih tidak selalu yang paling besar. Kernel memberi setiap proses sebuah nilai oom_score — makin tinggi, makin besar peluangnya dihentikan — yang dipengaruhi antara lain oleh jumlah memori yang dipakai dan lamanya proses berjalan.
cat /proc/<PID>/oom_score
cat /proc/<PID>/oom_score_adj
oom_score_adj adalah nilai yang bisa diatur administrator, dari -1000 (tidak pernah dipilih) sampai 1000 (paling mungkin dipilih). Nilai ini berguna untuk melindungi proses penting, misalnya database, agar tidak menjadi korban pertama.
5. Memastikan apakah server pernah mengalami OOM
Aplikasi yang mati mendadak tanpa jejak di log aplikasi sering disalahkan pada bug. Padahal prosesnya mungkin dihentikan dari luar, dan buktinya ada di log kernel:
sudo dmesg -T | grep -i -E 'out of memory|oom|killed process'sudo journalctl -k | grep -i -E 'out of memory|oom|killed process'Baris yang dicari kira-kira berbentuk seperti ini:
Out of memory: Killed process 1234 (php-fpm) total-vm:2048000kB, anon-rss:512000kBPesan itu menjelaskan kejadian yang tadinya misterius: worker php-fpm dihentikan kernel, dan Nginx melaporkan 502 karena tidak ada proses yang bisa melayani permintaan. Konfigurasi aplikasi memang tidak berubah — yang habis adalah memorinya.
Untuk layanan di dalam container, jejaknya juga bisa dikenali dari exit code. Proses yang dihentikan sinyal SIGKILL dari OOM Killer keluar dengan kode 137.
6. Memantau tanpa menunggu insiden
Angka sesaat jarang bercerita banyak. Yang berguna adalah pola: jam berapa pemakaian naik, proses apa yang tumbuh terus, dan apakah pertumbuhannya kembali turun setelah selesai.
Beberapa perintah yang cukup untuk sebagian besar kasus:
free -h— ringkasan RAM dan swap.topatauhtop— proses yang berjalan beserta penggunaan resource-nya, diperbarui berkala.ps aux --sort=-%mem | head -10— sepuluh proses dengan pemakaian memori terbesar.vmstat 1— aktivitas memori, swap, proses, dan I/O per detik.
Kebiasaan yang lebih baik: kirim metrik ini ke monitoring, lalu pasang peringatan pada tren available dan pada si/so, bukan hanya pada satu ambang pemakaian yang sesaat.
7. Mengurangi risiko kehabisan RAM
Tidak ada satu konfigurasi yang cocok untuk semua server. Yang ada hanya beberapa praktik yang secara umum memperkecil peluang:
-
Sesuaikan jumlah worker. PHP-FPM, Node.js, dan worker queue mengalikan kebutuhan memori per proses. Menambah worker tanpa menghitung batas memori adalah cara cepat memicu OOM.
-
Batasi memori container. Docker bisa dibatasi per service, sehingga satu aplikasi tidak menghabiskan RAM host:
services:
  app:
    image: nginx:alpine
    mem_limit: 512m
Catatan: batas yang terlalu kecil juga berbahaya. Container akan di-OOM meskipun host masih longgar, jadi angkanya perlu disesuaikan dengan kebutuhan aplikasi, bukan sekadar dibuat sekecil mungkin.
-
Perlakukan swap sebagai jaring pengaman. Swap memberi waktu untuk bereaksi saat ada lonjakan, bukan sebagai pengganti penambahan RAM.
-
Cari kebocoran memori. Pemakaian yang naik terus tanpa pernah turun, terutama setelah lonjakan trafik, biasanya bukan soal kapasitas melainkan bug atau cache yang tidak dibatasi.
-
Putuskan proses mana yang tidak boleh dikorbankan. Sesuaikan
oom_score_adjuntuk layanan yang paling penting, dan pastikan layanan lain bisa dijalankan ulang dengan aman. -
Tambahkan RAM kalau memang perlu. Kalau optimasi sudah dilakukan dan kebutuhan aplikasi tetap tumbuh, menambah kapasitas adalah jawaban yang jujur.
Penutup
Kehabisan RAM tidak membuat server langsung mati. Linux melewati beberapa tahap lebih dulu: melepas cache, memakai swap, lalu menghentikan satu proses lewat OOM Killer. Memahami tahapan itu mengubah cara membaca insiden — dari “server tiba-tiba mati” menjadi “proses ini dihentikan kernel, dan ada sebabnya”.
Kemampuan yang benar-benar dibutuhkan administrator bukan menghafal semua perintah di atas, melainkan tahu ke mana harus melihat ketika aplikasi berhenti tanpa penjelasan: available dan aktivitas swap di vmstat, lalu log kernel untuk mencari jejak OOM.
Referensi: Linux Kernel — Memory Management, Out of Memory Handling, free(1), dan vmstat(8) — dokumentasi resmi.